
Cum construim un baseline înainte de modificarea conținutului
Un baseline credibil nu este un singur scor salvat înainte de editare. Este un pachet înghețat de metrici, cohorte, răspunsuri brute, stare tehnică și variație în timp.
Dacă modificăm conținutul înainte să salvăm baseline-ul, nu mai putem reconstrui cinstit punctul de plecare. Un screenshot vechi sau un scor copiat într-un tabel nu ne spune ce prompturi au fost rulate, câte răspunsuri au eșuat, ce versiune a paginii era publică ori cât varia rezultatul de la o zi la alta.
Un baseline bun este un pachet de dovezi colectat înaintea intervenției. El fixează definițiile, păstrează observațiile brute și descrie condițiile în care au fost produse. Scopul lui nu este să arate rău sau bine, ci să permită o comparație ulterioară care nu schimbă regulile după rezultat.
1. Ce este baseline-ul și ce nu este
Un material de instruire găzduit în arhiva CDC definește datele baseline drept măsurători inițiale colectate înaintea unei intervenții. Ele oferă un punct de referință pentru schimbarea în timp și cer planificarea evaluării înainte de colectare. Materialul precizează că opiniile prezentatorului nu reprezintă neapărat poziția oficială CDC, de aceea îl folosim pentru definiția operațională, nu ca politică instituțională.
În vizibilitatea AI, baseline-ul nu este:
- cel mai bun răspuns găsit într-o sesiune;
- media unei zile alese convenabil;
- un export fără filtre și metodologie;
- o captură fără prompt, dată și suprafață;
- un scor recalculat ulterior cu o rubrică nouă;
- o estimare a efectului intervenției.
Baseline-ul răspunde la întrebarea „care era starea observabilă înainte?”. Articolul despre măsurarea impactului unei intervenții GEO preia această stare și explică analiza de după publicare.
2. Începem cu obiectivul și constructul măsurat
Înainte de primul prompt, scriem ce vrem să observăm. „Vizibilitate AI” poate însemna mențiune, citare, includere într-o listă, recomandare, acuratețe factuală sau referral. Aceste rezultate nu sunt interschimbabile.
Definim:
- unitatea de analiză: răspuns, conversație, scenariu, URL sau brand;
- evenimentul observabil care contează;
- metricile primare și secundare;
- populația la care vrem să generalizăm;
- intervalul temporal și suprafețele incluse;
- ce nu poate măsura protocolul.
NIST AI RMF Playbook recomandă documentarea ipotezelor din modelele de măsurare și verificarea faptului că proxy-urile reprezintă conceptul pretins. O mențiune nu este automat recomandare, iar o citare nu este automat aprobare.
3. Înghețăm contractul de măsurare
Contractul transformă obiectivul într-un calcul reproductibil. El conține:
- numărătorul și numitorul fiecărui KPI;
- rubrica de clasificare și exemplele-limită;
- regula pentru răspunsuri lipsă, refuzuri și timeouts;
- excluderile permise și cine le aprobă;
- rotunjirea, ponderarea și agregarea;
- pragul minim de coverage;
- formatul exportului și identificatorii obligatorii.
Dacă din 100 de scenarii 20 eșuează, nu calculăm rata numai pe cele 80 reușite fără să raportăm coverage. Dacă schimbăm ulterior definiția „recomandării”, păstrăm versiunea veche și recalculăm explicit; nu rescriem baseline-ul ca și cum noua regulă ar fi existat.
Ghidul despre KPI-uri și numitori pentru vizibilitatea AI detaliază separarea dintre eligibility, presence, citation și recommendation. În baseline salvăm formula exactă folosită.
4. Construim cohorta înainte să vedem răspunsurile
Cohorta este inventarul de scenarii pe care îl vom putea repeta. Pentru fiecare element păstrăm:
- ID stabil și versiune;
- promptul sau regula de generare;
- persona, obiectivul și constrângerile;
- branded, non-branded sau competitor discovery;
- limbă, țară și segment;
- pașii multi-turn și condiția de oprire;
- rezultatul așteptat numai dacă există un gold standard justificat.
Nu adăugăm după colectare doar întrebări la care brandul apare. Nu eliminăm scenariile dificile pentru că strică media. O cohortă utilă acoperă drumul real către decizie și păstrează atât cazurile favorabile, cât și absențele.
5. Fixăm mediul de rulare
Același text poate produce observații diferite în funcție de motor, suprafață, model afișat, instrumente de căutare, limbă, geografie, autentificare și moment. Salvăm ce putem observa fără să inventăm detalii interne:
- furnizor, produs și suprafață;
- interfață web sau API;
- modelul afișat, dacă este disponibil;
- search/browsing activ sau necunoscut;
- limbă, țară și fus orar;
- data, ora și identificatorul rulării;
- starea sesiunii: delogată, temporară sau cont de test dedicat.
Nu folosim contul personal pentru capturi editoriale. Dacă autentificarea este obligatorie, folosim doar un mediu de test aprobat și decupăm datele de cont; dacă nu există, marcăm suprafața drept netestată.
6. Colectăm mai multe valuri înainte de intervenție
Un singur val surprinde nivelul dintr-un moment, nu variația naturală. Când resursele permit, rulăm aceeași cohortă în mai multe zile și intervale. Păstrăm distribuția scenariilor comparabilă, dar putem randomiza ordinea pentru a nu confunda o familie de prompturi cu o anumită oră.
Nu există un număr universal de valuri. Alegerea depinde de raritatea evenimentului, volatilitate, cost, segmentare și mărimea schimbării pe care vrem să o detectăm ulterior. Declarăm criteriul înainte: de exemplu, minimum trei valuri complete și coverage peste prag în fiecare, fără a pretinde că această regulă este validă pentru orice proiect.
NIST AI RMF Measure cere procese de testare obiective și repetabile, documentarea seturilor, metricilor și uneltelor, măsuri ale incertitudinii și evaluare în condiții apropiate contextului de utilizare.
7. Păstrăm răspunsurile brute și toate eșecurile
Pentru fiecare rulare salvăm promptul integral, răspunsul fără rescriere, citările și URL-urile, timestampul, mediul și statusul. Clasificările sunt un strat derivat, nu înlocuitor pentru observația brută.
Un timeout, un refuz sau un răspuns gol rămâne în registru. Poate să nu intre în numărătorul de mențiuni, dar intră în coverage și explică de ce numitorul efectiv diferă. Eliminarea tăcută a eșecurilor poate transforma instabilitatea tehnică într-o îmbunătățire aparentă.
Fiecare transformare păstrează legătura cu sursa: output brut → afirmații extrase → clasificări → metrici. W3C PROV descrie proveniența prin entități, activități și agenți și susține atribuirea, derivarea, reproducibilitatea și versionarea.
8. Salvăm snapshotul conținutului și starea tehnică
Baseline-ul conversațional este incomplet fără versiunea paginii pe care urmează să o modificăm. Salvăm:
- URL-ul canonic și toate URL-urile din intervenție;
- HTML-ul și textul randat;
- titlul, descrierea, headings și datele structurate;
- robots, canonical, status HTTP și redirecturi;
- sitemap și legături interne relevante;
- captura paginii publice, dacă aduce dovadă;
- hash, timestamp și versiunea sursă.
Dacă editorul arată noul text, dar cache-ul servește versiunea veche, starea publică este cea servită. Dacă pagina canonicalizează către alt URL, notăm acest lucru înainte de a interpreta vizibilitatea.
9. Separăm semnalele first-party de cohorta externă
Search Console, analytics și referral logs folosesc alte definiții și numitori decât conversațiile eșantionate. Le păstrăm în baseline, dar pe fluxuri distincte.
Raportul Performance din Search Console permite metrici, dimensiuni și ferestre diferite; datele pot fi agregate la nivel de proprietate sau pagină, iar cele mai recente valori pot fi preliminare. Exportăm filtrul, proprietatea, search type, dimensiunile și intervalul, nu doar totalul.
Documentația dimensiunilor Search Console explică anonimizarea unor query-uri, trunchierea rândurilor și atribuirea majorității datelor către URL-ul canonic. Aceste limitări fac parte din baseline; nu le tratăm drept erori de export.
10. Măsurăm variația naturală, nu doar media
Pentru fiecare KPI raportăm valorile pe val, numărătorii, numitorii și dispersia. O medie de 30% poate proveni din valuri stabile de 29–31% sau din 10%, 30% și 50%. Cele două situații cer așteptări diferite pentru remăsurare.
O serie temporală poate folosi o linie centrală și limite de control pentru a semnala observații neobișnuite. NIST/SEMATECH descrie control charts ca instrumente de monitorizare a unei caracteristici în timp. Nu aplicăm mecanic regula „trei sigma” unei proporții mici sau unei serii autocorelate; alegem metoda potrivită distribuției și volumului.
Scopul baseline-ului este să estimeze intervalul obișnuit înainte de editare. Un punct din afara lui declanșează investigație, nu dovedește cauza.
11. Controlăm calendarul și granularitatea
Zilele săptămânii, sezonalitatea și evenimentele pot schimba semnalele first-party. Comparațiile trebuie să folosească ferestre compatibile. Google recomandă granularitate săptămânală sau lunară pentru a reduce efectul zilei săptămânii în comparații de durată, fără ca această agregare să înlocuiască analiza zilnică a anomaliilor.
Ghidul de comparații Search Console arată că filtrele pentru pagină, țară, dispozitiv, search type și date schimbă grupul comparat. În manifest salvăm exact aceleași dimensiuni pentru fereastra baseline și viitoarea fereastră post-intervenție.
12. Ținem un jurnal al contextului extern
În perioada baseline notăm evenimente care pot explica schimbări:
- update-uri de model, suprafață sau search;
- outage-uri și erori de instrumentare;
- știri majore și sezonalitate;
- publicarea unor surse importante în categorie;
- migrații, redirecturi și modificări de canonical;
- schimbări de tracking sau rubrică.
Nu excludem automat zilele neconvenabile. Le marcăm și definim dinainte când o anomalie tehnică justifică excluderea. Un val parțial rămâne vizibil chiar dacă nu intră în estimarea principală.
13. Pachetul minim al baseline-ului
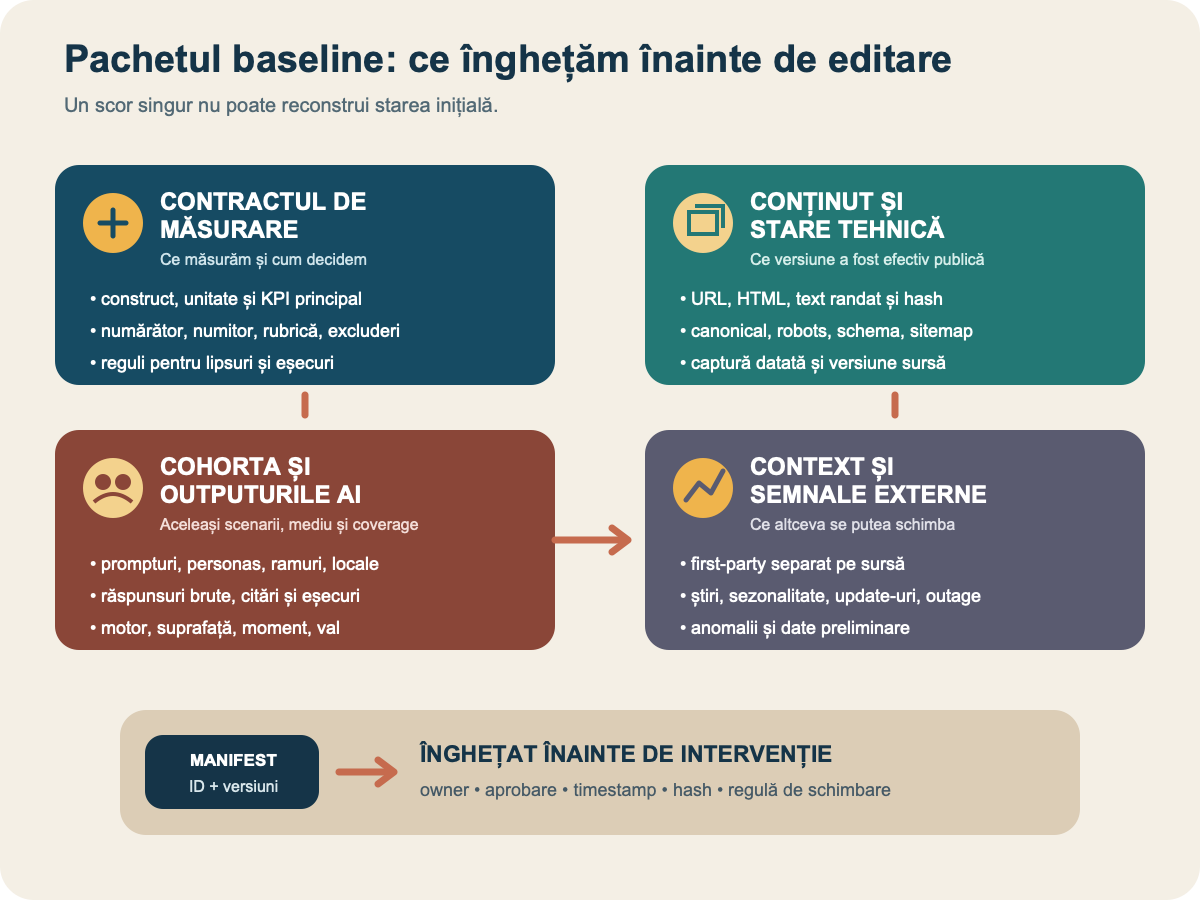
Manifestul leagă toate fișierele prin ID-uri și versiuni. Conține ownerul, aprobatorul, timestampul înghețării, hash-urile și regula de schimbare. Orice corecție ulterioară produce o versiune nouă; baseline-ul inițial rămâne inspectabil.
14. Criteriul de acceptare înainte de editare
Nu începem intervenția până când:
- constructul și KPI-ul principal sunt definite;
- cohorta și excluderile au versiune;
- fiecare val raportează coverage și eșecuri;
- avem suficiente valuri pentru criteriul declarat;
- snapshotul public al paginii este verificat;
- first-party și observațiile externe sunt separate;
- anomaliile cunoscute sunt documentate;
- manifestul este semnat și înghețat.
Dacă lipsesc date, baseline-ul poate fi acceptat cu limitări explicite sau colectarea continuă. Nu completăm retrospectiv golurile cu presupuneri.
15. Ce nu poate demonstra baseline-ul
Un baseline complet nu demonstrează că o viitoare schimbare va produce efect. Nu elimină update-urile de model, schimbările concurențiale sau contaminarea dintre pagini. Nu transformă un eșantion convenabil într-unul reprezentativ și nu face un proxy valid prin simpla repetare.
El face altceva esențial: reduce libertatea de a schimba definițiile după rezultat și păstrează starea inițială suficient de clar pentru o comparație onestă. Google avertizează că apropierea temporală dintre schimbarea unei pagini și performanță nu stabilește singură cauza, deoarece pot interveni interesul utilizatorilor, știrile și schimbările concurenților.
Verdict
Baseline-ul pentru vizibilitatea AI nu este o fotografie frumoasă a zilei de ieri. Este un contract de măsurare, o cohortă versionată, o serie de observații brute, un snapshot tehnic și un jurnal al contextului, reunite într-un manifest înghețat înainte de editare.
Dacă putem reconstrui cine a măsurat, ce, unde, când, cu ce reguli și pe ce versiune de conținut, avem un punct de plecare. Dacă păstrăm numai scorul, avem o amintire, nu un baseline.
Surse
- CDC — Establishing a Baseline as Part of Your Evaluation
- NIST AI RMF Core — Measure
- NIST AI RMF Playbook — Measure
- NIST/SEMATECH — Control charts
- Google Search Console — Performance report overview
- Google Search Console — Advanced filtering and comparison
- Google Search Console — Measuring the impact of page changes
- Google Search Console — Dimensions and data groupings
- W3C — PROV Overview
Sursele au fost verificate la 2 august 2026. Articolul descrie o metodologie editorială de baseline și nu afirmă existența unei funcții AYSA de monitorizare, experimentare sau atribuire a impactului.