
Bucla completă AYSA: măsoară, explică, aprobă, execută, remăsoară
Cum legăm măsurarea, explicația, aprobarea, execuția și remăsurarea fără să confundăm metodologia cu funcțiile AYSA verificate.
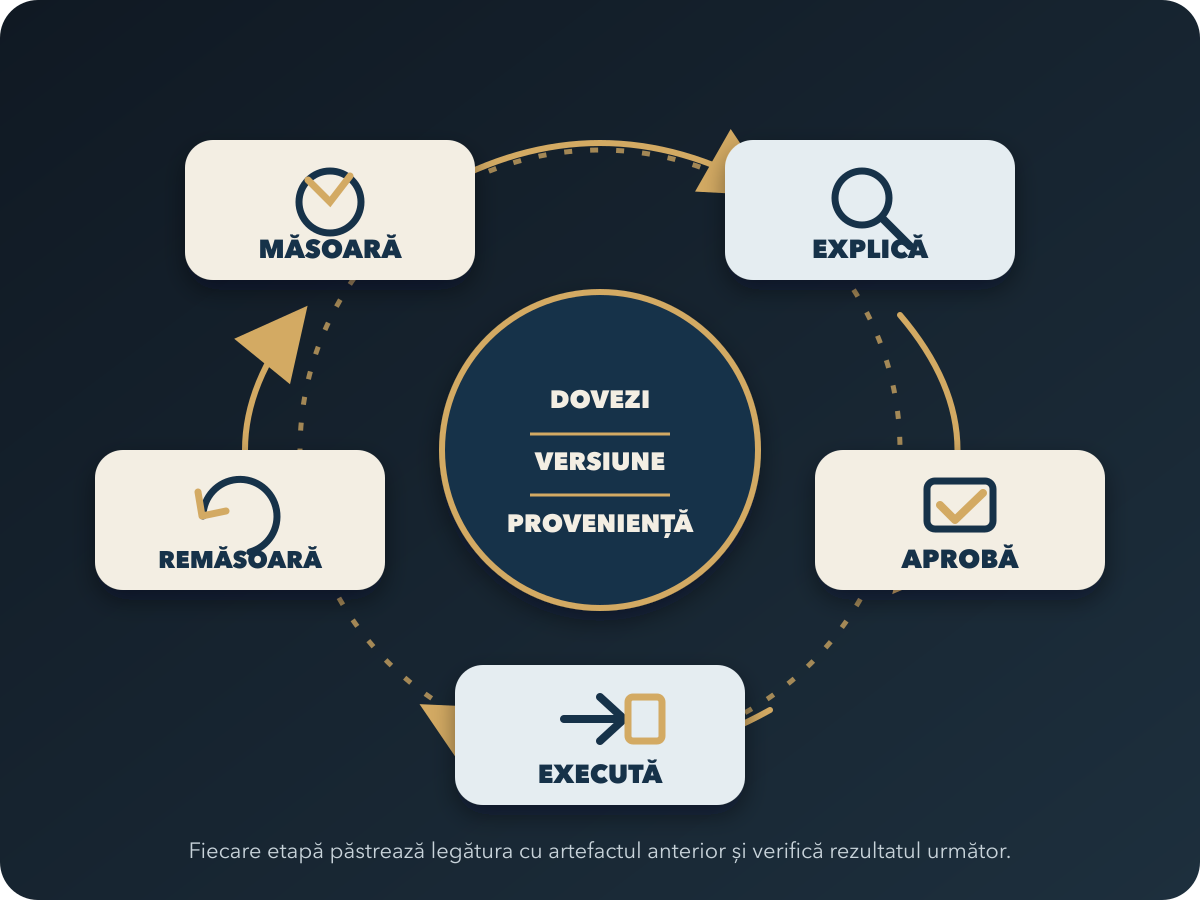
O platformă de vizibilitate AI nu este completă doar pentru că afișează un scor. Valoarea apare când organizația poate lega cinci etape fără să piardă dovezile dintre ele: măsoară o situație reproductibilă, explică rezultatul, aprobă o intervenție exactă, execută numai schimbarea autorizată și remăsoară în condiții comparabile.
Numim această succesiune bucla completă de îmbunătățire. Ea nu promite că o modificare de conținut va determina un model AI să recomande brandul. Produce ceva mai util: o evidență controlată despre ce am observat, ce am schimbat și ce putem sau nu putem atribui intervenției.
În acest articol separăm riguros metoda de produs. Cadrul în cinci etape poate fi aplicat manual sau cu mai multe instrumente. Pentru AYSA folosim inventarul exhaustiv verificat la 2 august 2026 pe versiunea 1.5.0: 21 de funcții, toate reconciliate, fără intrări omise. O funcție planificată, un mock sau o descriere comercială nu este prezentată drept capabilitate disponibilă.
Răspunsul scurt: cum arată bucla completă
- Măsoară: fixează cohorta, scenariile, motoarele, numitorii și fereastra de observare.
- Explică: păstrează răspunsurile, mențiunile, citările și limitele care susțin concluzia.
- Aprobă: transformă insightul într-o schimbare precisă, cu owner, versiune, risc și termen de expirare.
- Execută: aplică numai diferența autorizată, printr-un canal canonic, cu teste și posibilitate de revenire.
- Remăsoară: repetă un protocol compatibil și separă asocierea temporală de dovada cauzală.
Etapele sunt legate, dar nu sunt interschimbabile. Un dashboard nu este explicație. O explicație nu este aprobare. Un răspuns HTTP 200 nu dovedește că schimbarea live este cea autorizată. O creștere observată după publicare nu dovedește singură că intervenția a provocat-o.
De ce un scor izolat nu închide bucla
Un scor de vizibilitate este rezultatul unui contract de măsurare. Valoarea lui depinde de întrebările incluse, persona, piață, limbă, motor, moment, numărul de repetări și regula după care clasificăm o mențiune sau o recomandare. Dacă aceste elemente se schimbă fără să fie documentate, două valori identice pot descrie realități diferite, iar două valori diferite pot proveni doar dintr-o schimbare de metodă.
De aceea păstrăm atât rezultatul agregat, cât și unitățile din care a fost calculat. Articolul despre scorul de vizibilitate AI explică formula; aici ne interesează traseul ulterior. Fără conversațiile și dovezile de sub scor nu putem decide ce intervenție are sens. Fără versiunea intervenției nu putem demonstra ce s-a executat. Fără o remăsurare compatibilă nu putem evalua dacă observația s-a schimbat.
NIST descrie măsurarea drept o activitate care combină metode cantitative, calitative sau mixte, benchmarkuri, incertitudine, raportare și documentare. Același cadru cere ca măsurarea și gestionarea riscului să continue pe durata ciclului de viață, nu să fie tratate ca un test singular.
1. Măsoară: îngheață contractul înainte de rezultate
Prima etapă nu începe cu un grafic, ci cu un manifest. El declară ce vrem să observăm și ce nu acoperă experimentul:
- brandul, produsele și concurenții incluși;
- piața, limba, persona și intenția scenariilor;
- lista literală de prompturi și ordinea lor;
- motoarele și suprafețele testate, inclusiv versiunea vizibilă când este disponibilă;
- numărul de repetări, fereastra și tratamentul erorilor;
- definițiile pentru mențiune, citare, recomandare și poziție;
- numitorii, coverage-ul minim și regulile pentru date lipsă.
Manifestul se îngheață înaintea colectării. Dacă îl modificăm după ce vedem răspunsurile, marcăm o versiune nouă sau un series break. Nu eliminăm discret prompturile nefavorabile și nu schimbăm numitorul pentru a obține un procent mai atrăgător.
NIST AI RMF Core subliniază selectarea metodelor și metricilor potrivite, documentarea lucrurilor care nu pot fi măsurate și reevaluarea regulată a controalelor. Acest principiu este util și pentru vizibilitatea AI, chiar dacă obiectul evaluat aici este prezența unui brand în răspunsuri, nu conformitatea cu întregul cadru NIST.
2. Explică: de la indicator la lanțul de dovezi
Explicația credibilă răspunde la întrebarea „de unde știm?”. Pentru fiecare concluzie păstrăm conversația brută, data, scenariul, suprafața, etichetele aplicate și sursele citate de motor. Apoi diferențiem trei niveluri:
- observație: ce apare efectiv în răspuns;
- interpretare: ce tipar propun datele agregate;
- ipoteză de intervenție: ce schimbare ar putea influența acel tipar.
Faptul că o pagină nu este citată într-un eșantion nu dovedește că motorul nu o poate accesa. Faptul că un concurent este recomandat nu dovedește că o singură sursă a determinat recomandarea. Iar o explicație generată de același model nu devine automat dovadă despre mecanismul intern al sistemului.
Proveniența ajută la păstrarea legăturilor. W3C PROV-DM modelează entități, activități și agenți pentru a putea evalua calitatea, fiabilitatea și încrederea într-un rezultat. Nu este necesară implementarea completă a standardului, dar fiecare insight ar trebui să indice datele și procesul care l-au produs.
3. Aprobă: insightul nu are singur drept de scriere
O recomandare de optimizare este o propunere, nu o permisiune. Înaintea execuției, organizația trebuie să vadă ținta exactă, versiunea curentă, diferența propusă, sursele, riscul, testele, ownerul și fereastra în care aprobarea poate fi folosită.
Aprobarea se leagă de o versiune determinată. Dacă altcineva modifică pagina între review și execuție, vechea aprobare expiră. Sistemul recalculează diferența față de starea actuală și cere o decizie nouă. Această regulă împiedică suprascrierea muncii recente și executarea unei combinații pe care aprobatorul nu a văzut-o.
Riscul stabilește nivelul de control. Corectarea unei greșeli fără schimbare de sens poate intra într-o politică preaprobată și limitată. Prețurile, promisiunile, canonicalurile, redirecturile sau template-urile globale cer o autoritate mai strictă. Detaliile sunt tratate în ghidul despre aprobarea modificărilor automate.
4. Execută: aplică pachetul aprobat, nu o intenție vagă
Execuția primește un artefact determinist. Acesta declară obiectele afectate, operațiile, precondițiile, permisiunile minime, testele înainte și după scriere, limita de propagare și metoda de rollback. Ghidul despre execution bundle descrie componentele în detaliu.
Un canal canonic de execuție evită implementările paralele. Dacă WordPress este sursa de adevăr pentru articol, schimbarea trebuie să respecte identificatorul postării, revizia, media și automatizările deja existente. Nu publicăm o copie pe o rută alternativă doar pentru că este mai simplu tehnic.
Răspunsul API nu este proba finală. După scriere verificăm conținutul live, H1, canonical, hreflang, linkuri, imagini, date structurate, indexabilitate și absența schimbărilor în afara țintei. WordPress Revisions permite inspectarea și restaurarea versiunilor, dar rollback-ul nu înlocuiește aprobarea: o informație greșită poate fi distribuită înainte de revenire.
5. Remăsoară: compară condiții compatibile
Remăsurarea folosește același contract sau declară explicit diferențele. Păstrăm scenariile, etichetele și numitorii compatibili; controlăm pe cât posibil piața, limba, suprafața și fereastra. Dacă motorul sau produsul se schimbă material, marcăm întreruperea seriei și nu lipim mecanic valorile într-un singur trend.
Comparația trebuie să includă incertitudinea și datele lipsă. Un salt de la trei recomandări din zece la patru din zece nu este echivalent cu un salt de la 300 din 1.000 la 400 din 1.000. Repetările reduc o parte din variabilitate, dar nu transformă un experiment observațional într-un test cauzal.
Google oferă un exemplu practic pentru evaluarea schimbărilor de structured data: recomandă pagini cu istoric suficient, validarea implementării și observarea performanței pe o perioadă relevantă. Documentația avertizează și că markupul corect oferă eligibilitate, nu garanția unei apariții. În același fel, conținutul mai clar poate fi o intervenție rezonabilă fără să garanteze o recomandare într-un răspuns AI.
Ce leagă etapele: identitate, versiune și proveniență
Bucla se rupe când fiecare instrument folosește alt identificator. Un insight trebuie să indice cohorta și conversațiile. Propunerea trebuie să indice insightul. Aprobarea trebuie să indice versiunea propunerii. Execuția trebuie să indice aprobarea și starea inițială. Remăsurarea trebuie să indice intervenția și noul protocol.
Pentru fiecare obiect păstrăm cel puțin:
- identificator stabil și versiune;
- momentul creării și ultima verificare;
- actorul sau procesul responsabil;
- sursele și artefactele de intrare;
- starea: propus, validat, aprobat, executat, verificat sau respins;
- relația cu obiectul anterior și următor din buclă.
Acest audit trail nu dovedește automat că decizia a fost bună. Dovedește însă ce decizie s-a luat, pe baza căror date și ce rezultat a fost verificat. Este fundația necesară pentru review și învățare.
Unde se află AYSA în această buclă
Inventarul AYSA verificat pentru această ediție conține 21 de funcții: cinci disponibile, zece beta, trei planificate, două încadrate numai ca metodologie și una nesuportată în combinația declarată. Inventarul acoperă toate cele cinci etape și reconciliază 21 de intrări importate din 21 de intrări sursă, fără excluderi.
Statusul unei funcții nu este verdictul release-ului. AYSA AI SEO Plugin 1.5.0 și Agent8 rămân, la data verificării, NO-GO / IN PROGRESS pentru lansarea controlată către primele zece companii. Putem descrie funcțiile probate și limitele lor, dar nu putem transforma această matrice într-o afirmație că întregul produs este gata de lansare.
| Etapă | Ce este verificat în AYSA 1.5.0 | Status și limită principală |
|---|---|---|
| Măsoară | Măsurare manuală a vizibilității și conversații multi-turn pe ChatGPT | Disponibile; cohorta cere motor configurat, estimare, plafon și aprobare |
| Măsoară | Monitorizare automată recurentă | Beta; implicit oprită și dependentă de politică, confirmare și buget |
| Măsoară | Multi-turn în Google AI Mode | Nesuportat; combinația este refuzată înainte de provider și billing |
| Explică | Dovezi întrebare–răspuns–interpretare–sursă, KPI organici și explicarea eșantionului | Disponibile; citarea nu garantează acuratețe, iar eșantioanele mici rămân neconcludente |
| Explică | Recomandări cu baseline și Knowledge Base WordPress | Beta; recomandările sunt propuneri, iar sursele oficiale cer validare factuală |
| Explică | Ingestie din sitemap extern și documente de încredere | Planificată; fără acceptanță live și fără rută publică verificată |
| Aprobă | Profil SEO ghidat, aprobare cu estimare/plafon și handoff către fluxurile SEO | Beta; confirmarea este obligatorie, iar handoff-ul nu aplică singur schimbarea |
| Execută | Technical SEO, Image ALT și metadata On-Page cu readback | Beta; numai lane-urile controlate, cu selecție și verificare, pot scrie |
| Execută | Aplicare AEO automată și publicare GBP cu rollback | Planificate; nu trebuie prezentate ca funcții disponibile |
| Remăsoară | Impact după intervenție | Beta; funcționează numai pentru lane-uri cu write și readback complet |
| Remăsoară | Corelarea surselor și atribuirea cauzală automată | Numai metodologie; comparația descriptivă nu demonstrează cauzalitate |
Inventarul complet al celor 21 de funcții verificate
Tabelul de mai jos este deliberat complet. Funcțiile cu status „planificat” sau „numai metodologie” sunt incluse pentru a face limitele vizibile, nu pentru a le promova ca disponibile.
| # | Funcție | Etapă | Status | Limită verificată |
|---|---|---|---|---|
| 1 | Configurare ghidată a profilului SEO prin Agent8 | Aprobă | Beta | Checkpointul și reluarea sunt probate; traversarea integrală actuală RO/EN rămâne deschisă |
| 2 | Măsurare manuală a vizibilității în răspunsuri AI | Măsoară | Disponibil | Necesită motor configurat, estimare, plafon și aprobare |
| 3 | Testarea conversațiilor multi-turn pe ChatGPT | Măsoară | Disponibil | Consumă credite numai după aprobarea cohortei |
| 4 | Testarea conversațiilor multi-turn în Google AI Mode | Măsoară | Nesuportat | Google AI Mode rămâne numai pentru scenarii single-turn compatibile |
| 5 | Dovezi întrebare → răspuns → interpretare → sursă | Explică | Disponibil | Payloadul provider brut nu este expus; citarea nu garantează acuratețea |
| 6 | Indicatori de recomandare, vizibilitate și citare | Explică | Disponibil | Testele branded/forced sunt excluse din KPI-urile organice |
| 7 | Explicarea rezultatelor și a limitelor eșantionului | Explică | Disponibil | Nu afirmă cauzalitate; valorile sub prag sunt neconcludente |
| 8 | Recomandări cu baseline și destinație SEO | Explică | Beta | Recomandările sunt proposal-only și baseline-ul trebuie afișat |
| 9 | Aprobare cu estimare și plafon de cost | Aprobă | Beta | Necesită confirmare exactă; schedulerul automat este implicit oprit |
| 10 | Execuție controlată în Technical SEO | Execută | Beta | Numai modulele cu contract complet pot scrie; deschiderea modalelor este read-only |
| 11 | Optimizare controlată Image ALT | Execută | Beta | Necesită candidați selectabili, confirmare, billing și readback |
| 12 | Optimizări metadata On-Page cu readback | Execută | Beta | Content rewrite general și apply-all rămân blocate |
| 13 | Aplicare AEO automată | Execută | Planificat | Nu există rută publică verificată de aplicare |
| 14 | Trimiterea recomandărilor aprobate către fluxurile SEO existente | Aprobă | Beta | Dispatchul este non-billable și nu aplică singur schimbări |
| 15 | Remăsurarea impactului după intervenție | Remăsoară | Beta | Necesită lane cu write și readback complet; acceptanța multi-lane rămâne deschisă |
| 16 | Corelarea surselor AI, GSC, GA, referral și GBP | Remăsoară | Numai metodologie | Comparația este descriptivă și nu reprezintă atribuire cauzală |
| 17 | Monitorizare automată recurentă AI Visibility | Măsoară | Beta | Implicit oprită; cere confirmare recurentă, quote/policy și buget |
| 18 | Knowledge Base din conținut WordPress publicat | Explică | Beta | Sursele oficiale cer verificare factuală și nu generează automat afirmații |
| 19 | Crawl de sitemap extern și scanarea documentelor de încredere pentru Knowledge Base | Explică | Planificat | Nu există acceptanță live sau rută publică verificată |
| 20 | Publicarea automată în Google Business Profile cu rollback verificat | Execută | Planificat | Publish, readback și rollback nu sunt încă probate împreună |
| 21 | Atribuire cauzală automată a creșterii SEO | Remăsoară | Numai metodologie | AYSA compară baseline-uri și readback-uri, dar nu atribuie automat cauzalitatea |
Ultima verificare a acestei matrice: 2 august 2026, AYSA AI SEO Plugin 1.5.0. Orice schimbare de versiune, suprafață sau verdict de acceptanță cere o revizie nouă a inventarului înainte de actualizarea articolului.
Exemplu complet fără promisiuni cauzale
Un audit observă că brandul apare în 18 din 60 de conversații eligibile și este recomandat în 7. Pentru scenariile cu intenție de achiziție, răspunsurile citează frecvent pagini terțe și rareori pagina oficială care explică politica de retur. Concluzia factuală este limitată la cohorta și fereastra măsurate.
Echipa formulează ipoteza că pagina oficială nu răspunde clar întrebărilor recurente și pregătește o intervenție: o secțiune vizibilă, cu condiții și exemple confirmate de ownerul comercial. Editorul aprobă versiunea exactă, iar executorul o publică numai după validarea linkurilor, structurii și datelor. Starea live este verificată și snapshotul este păstrat.
După o fereastră stabilită, echipa repetă protocolul. Recomandările cresc la 11 din 60, iar pagina oficială apare în mai multe citări. Raportul spune că îmbunătățirea este asociată temporal cu intervenția și este compatibilă cu ipoteza. Nu afirmă că intervenția a produs singură schimbarea: motorul, webul și răspunsurile pot varia, iar alte evenimente pot contribui.
Semnale că bucla este doar aparent completă
- scorul nu poate fi reconstruit din conversații și numitori;
- explicația nu indică sursa ori confundă observația cu mecanismul;
- recomandarea poate scrie fără aprobare sau politică limitată;
- aprobarea nu este legată de o versiune și expirare;
- executorul poate modifica obiecte în afara scope-ului;
- succesul este definit doar prin răspunsul API, nu prin starea live;
- baseline-ul este reconstruit după intervenție;
- remăsurarea schimbă prompturile ori numitorul fără series break;
- orice creștere este prezentată drept efect cauzal garantat.
Checklist pentru o buclă auditabilă
- contractul de măsurare este înghețat înaintea colectării;
- datele brute și coverage-ul rămân accesibile sub agregate;
- observația, interpretarea și ipoteza sunt etichetate separat;
- intervenția are țintă, diff, risc, owner și dovezi;
- aprobarea aparține unei versiuni exacte și poate expira;
- execuția folosește canalul canonic și permisiuni minime;
- rollback-ul și verificările live sunt definite înainte de scriere;
- remăsurarea păstrează o cohortă compatibilă sau declară ruptura;
- raportul include incertitudine, limitări și explicații alternative;
- statusurile produsului sunt susținute de dovezi reproductibile.
Bucla completă nu este o promisiune de control asupra modelelor AI. Este un sistem de control asupra propriilor măsurători, decizii și schimbări. Această diferență face rezultatul auditabil și permite organizației să învețe fără să confunde o corelație convenabilă cu o certitudine.
Surse
- NIST — AI Risk Management Framework Core
- NIST — AI RMF Playbook
- W3C — PROV Data Model
- WordPress.org — Revisions
- Google Search Central — Introduction to structured data
- Google Search Central — General structured data guidelines
Sursele metodologice au fost reverificate la 3 august 2026. NIST precizează că AI RMF 1.0 este în curs de actualizare. Inventarul AYSA a fost verificat la 2 august 2026 pe versiunea 1.5.0; statusurile descriu funcțiile individuale, nu un verdict general de lansare al produsului.