
Cum selectează Perplexity sursele și citările
Perplexity caută, sintetizează și afișează citări, dar lista vizibilă nu dezvăluie întregul set recuperat sau formula de selecție. Iată cum audităm corect fiecare relație.
Perplexity afișează citări și linkuri lângă răspunsuri, dar acestea nu dezvăluie automat toate paginile recuperate, formula de selecție sau adevărul fiecărei propoziții. Putem observa URL-ul citat, poziția lui și textul răspunsului. Putem deschide pagina și verifica pasajul. Nu putem reconstrui complet candidații, scorurile și filtrele interne numai din interfață.
Această limită nu face citările inutile. Dimpotrivă, le transformă într-un obiect auditabil. Separăm accesibilitatea paginii, apariția în lista vizibilă, maparea la afirmație, calitatea suportului și sursa originară. Abia după aceea calculăm frecvențe sau formulăm o ipoteză editorială.
1. Descrierea oficială este generală, nu o formulă de ranking
Perplexity descrie propriul flux prin înțelegerea întrebării, căutarea web, sintetizarea informațiilor și citarea surselor. Documentația explică produsul la nivel conceptual, dar nu publică ponderi, lista completă de candidați sau o regulă prin care un editor poate prezice sigur URL-ul ales.
De aceea titlul „cum selectează” trebuie citit ca analiză a porților documentate și a semnalelor observabile, nu ca dezvăluire a algoritmului. Orice afirmație mai precisă cere fie documentație tehnică explicită, fie un experiment controlat cu limitări.
Și vocabularul de marketing trebuie atribuit. Când furnizorul spune că folosește surse „credibile” sau „de calitate”, aceasta este poziția produsului. Auditorul verifică independent autoritatea, actualitatea și potrivirea fiecărei pagini pentru afirmația concretă.
2. Întrebarea și modul schimbă universul de surse
O interogare despre o definiție, una despre o știre recentă și una despre alegerea unui produs cer surse diferite. Formularea, limba, țara și perioada pot schimba subîntrebările și paginile relevante. Într-o conversație, turnurile anterioare pot restrânge sensul fără ca acele cuvinte să fie repetate.
Documentația Pro Search arată că modul de căutare, modelul ales și tipul de surse pot varia. Pentru măsurare salvăm exact suprafața și setările observabile; nu combinăm Standard, Pro, Research, web, fișiere sau baze premium într-o singură cohortă.
Același prompt rulat în două moduri poate produce surse diferite fără ca vreun rezultat să fie „bug”. Întrebarea de audit este dacă fiecare rezultat respectă propriul contract și dacă citările lui susțin textul afișat.
3. Accesibilitatea este o poartă, nu o garanție
Documentația oficială a crawlerelor separă PerplexityBot, folosit pentru indexarea și apariția site-urilor în rezultate, de Perplexity-User, asociat unor vizite inițiate de întrebarea utilizatorului. Sunt roluri diferite și trebuie identificate separat în loguri.
Permiterea crawlerului, a adreselor IP și a accesului prin WAF poate face pagina accesibilă. Nu promite recuperarea pentru un prompt, folosirea pasajului sau citarea. O pagină poate fi tehnic disponibilă și totuși irelevantă, duplicată, neactuală sau depășită de o sursă mai potrivită.
Perplexity afirmă în politica sa actuală despre robots.txt că PerplexityBot nu indexează textul paginii când este blocat, deși domeniul, titlul și un rezumat factual scurt pot rămâne indexabile. În audit notăm această nuanță și data verificării, fiindcă politicile se pot schimba.
4. Recuperat, folosit și citat sunt trei mulțimi
Un motor poate recupera mai multe pagini decât afișează. Unele pot furniza context, altele pot fi eliminate, iar un subset primește citări vizibile. Fără loguri interne nu știm complet componența primelor două mulțimi.
De aceea nu numim lista de citări „toate sursele folosite”. O denumim exact: URL-uri citate în răspuns. Dacă interfața oferă o listă mai largă de surse consultate, o păstrăm separat și documentăm ce înseamnă acel câmp în versiunea observată.
Articolul despre stările unei surse în motoarele AI dezvoltă taxonomia generală. Pentru Perplexity, regula operațională este simplă: măsurăm numai mulțimea pe care o putem demonstra și nu umplem golurile cu presupuneri despre retrieval.
5. Numărul citării trebuie legat de afirmația exactă
O citare după un paragraf poate susține prima propoziție, ultima sau numai o valoare. Auditorul împarte textul în afirmații atomice și mapează fiecare marker la claim-ul lui. Fraza cu preț, disponibilitate și certificare conține trei afirmații, chiar dacă are un singur număr de citare.
Deschidem URL-ul final după redirect și căutăm pasajul. Păstrăm titlul, autorul, data publicării, data actualizării, calificatorii și contextul. Dacă pagina spune „de la 100 lei în planul anual”, nu marcăm drept suport complet pentru „costă 100 lei lunar”.
O citare corectă la nivel de domeniu poate fi greșită la nivel de pagină sau pasaj. De aceea verificarea nu se oprește când faviconul pare familiar.
6. Corectitudinea și completitudinea sunt axe diferite
Cercetarea publicată în Findings of EMNLP despre verificabilitatea motoarelor generative separă două întrebări: citarea indicată susține afirmația și afirmațiile care ar trebui susținute au citări? Acestea sunt citation correctness și citation completeness.
Un răspuns poate avea cinci citări corecte, dar alte șase afirmații factuale fără suport. Sau poate cita fiecare propoziție, însă două linkuri nu conțin dovada necesară. Numărul mare de markeri nu rezolvă niciuna dintre probleme.
În raport folosim verdicturi explicite: suport complet, suport parțial, contradicție, pasaj indisponibil și neconfirmat. „Neconfirmat” nu este automat fals; înseamnă că dovada accesibilă nu permite verdictul cerut.
7. Sursa citată poate să nu fie sursa originară
Un articol poate rezuma un raport, un comunicat sau o bază de date și poate fi citat pentru cifra preluată. El susține că informația există, dar nu este originea ei. Pentru fapte sensibile, valori și afirmații despre un brand, urmărim lanțul până la sursa primară când este disponibilă.
În ledger păstrăm `cited_url`, `origin_url` și relația dintre ele. Dacă pagina citată adaugă analiză originală, o credităm pentru acea contribuție. Dacă doar reproduce o cifră, atribuim cifra sursei care a produs-o.
Această distincție împiedică un diagnostic greșit: „motorul preferă publicația X” poate însemna doar că X a republicat rapid informația și a fost URL-ul vizibil într-un eșantion mic.
8. Exemplu fictiv: patru surse, trei afirmații
Presupunem o întrebare despre piața românească a unui serviciu fictiv. Răspunsul afirmă că piața a crescut cu 18%, că Brandul Molid oferă funcția X și că produsul este certificat pentru un anumit standard. Sunt afișate patru surse.
Sursa 1 este raportul statistic și susține direct cifra, perioada și geografia. Sursa 2 este pagina oficială de produs și susține funcția X, dar numai pentru planul Enterprise; răspunsul a omis calificatorul, deci verdictul este parțial. Sursa 3 este un articol care citează registrul de certificare, iar verificarea ajunge la registrul originar. Sursa 4 apare în listă, dar nu poate fi mapată la vreo afirmație vizibilă.
Nu raportăm „patru surse corecte”. Raportăm o citare completă, una parțială, un lanț secundar-originar și o sursă asociată fără contribuție observabilă. Exemplul este metodologic, nu un rezultat Perplexity real.
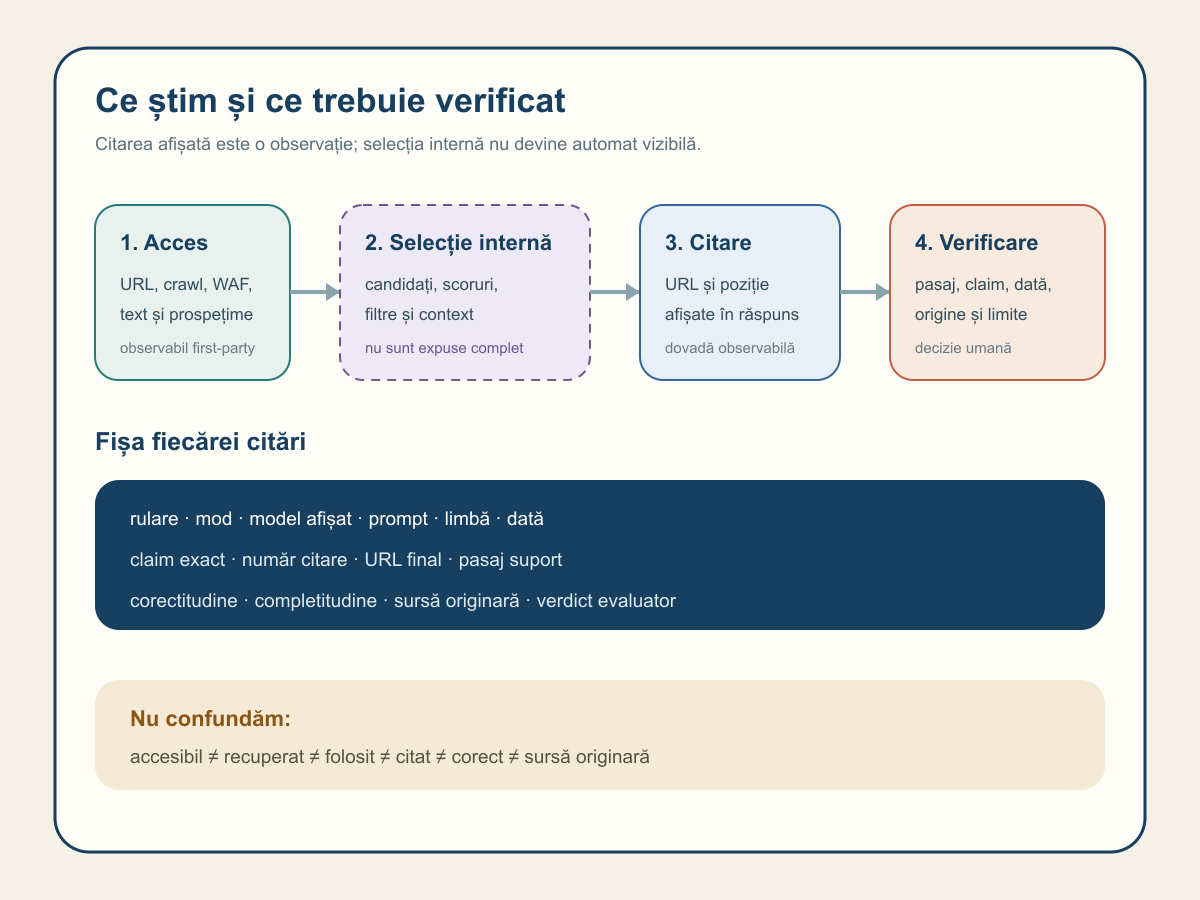
9. Ledgerul minim pentru fiecare citare
- ID-ul rulării, promptul și contextul relevant;
- modul, modelul afișat, tipul surselor, limba și momentul;
- răspunsul integral și afirmația atomică;
- numărul sau markerul citării și poziția lui;
- URL-ul afișat, URL-ul final, domeniul și statusul HTTP;
- titlul, autorul, datele și pasajul de suport;
- verdictul de corectitudine și completitudine;
- sursa originară, dacă diferă;
- evaluatorul, data verificării și motivarea deciziei.
Captura poate documenta poziția markerului, dar ledgerul păstrează textul și URL-urile în formă procesabilă. Nu folosim conturi personale sau elemente de navigație private pentru dovezi editoriale.
10. Metricile au numitori diferiți
Citation presence poate număra răspunsurile care includ cel puțin un URL al brandului. Citation frequency poate număra aparițiile URL-urilor. Claim support rate folosește afirmațiile care cer dovadă. Source originality rate folosește citările pentru care poate fi identificată o origine.
Aceste procente nu sunt interschimbabile. Trei markeri către același URL într-un răspuns pot însemna o singură sursă, trei apariții și trei claim-uri. Raportul afișează unitatea și numitorul, conform regulilor explicate în ghidul despre numitorii KPI-urilor AI.
Răspunsurile eșuate și paginile inaccesibile rămân în coverage. Excluderea lor după rezultat ar face rata să pară mai bună decât testul.
11. Ce poate îmbunătăți o pagină fără promisiuni magice
O pagină are nevoie de acces tehnic, identitate clară, afirmații precise, calificatori, data actualizării și dovada potrivită. Tabelele și definițiile trebuie să rămână adevărate când sunt extrase. Pentru cifre originale publicăm metoda și sursa datelor.
Aceste practici fac pagina mai ușor de evaluat și citat, dar nu garantează alegerea. Articolul despre conținut care merită citat explică anatomia unității citabile. Aici măsurăm dacă Perplexity a afișat-o și dacă legătura este corectă.
Nu creăm fișiere pseudo-tehnice fără suport oficial și nu multiplicăm pagini aproape identice pentru fiecare prompt. Mai întâi reparăm accesul, adevărul și originea dovezii.
12. Ce nu putem concluziona
Nu putem spune că o pagină a avut un anumit scor intern, că fiecare sursă recuperată a influențat răspunsul sau că un URL necitat nu a fost consultat. Nu putem deriva ponderi stabile din ordinea citărilor și nu putem transforma o observație într-o preferință permanentă.
Nici crawlerul observat în log nu dovedește citarea ulterioară. Arată o vizită. Legătura cauzală dintre modificarea paginii și apariție cere baseline, versiune, cohortă comparabilă și repetări.
Checklist de audit
- fixează întrebarea, modul, sursele și contextul;
- păstrează răspunsul integral;
- extrage afirmațiile atomice;
- mapează fiecare marker la claim;
- rezolvă redirecturile și arhivează URL-ul final;
- verifică pasajul, data, geografia și calificatorii;
- separă suportul complet, parțial și absent;
- urmărește sursa originară;
- nu echivalează lista citată cu retrievalul complet;
- raportează numitorul fiecărei metrici;
- păstrează erorile și inaccesibilitatea în coverage;
- repetă cohorta înainte de concluzii despre schimbare.
Verdict
Perplexity face citările vizibile și verificabile, dar verificarea rămâne munca auditorului. Calea solidă este de la marker la afirmație, de la afirmație la pasaj și de la pasaj la sursa originară. Orice explicație despre selecția internă care depășește documentația și experimentul trebuie marcată drept ipoteză.