
ChatGPT în browser vs API: de ce rezultatele nu sunt echivalente
Același prompt nu produce un test echivalent în ChatGPT și API. Modelul, instrucțiunile, starea, personalizarea și instrumentele trebuie contractate separat.
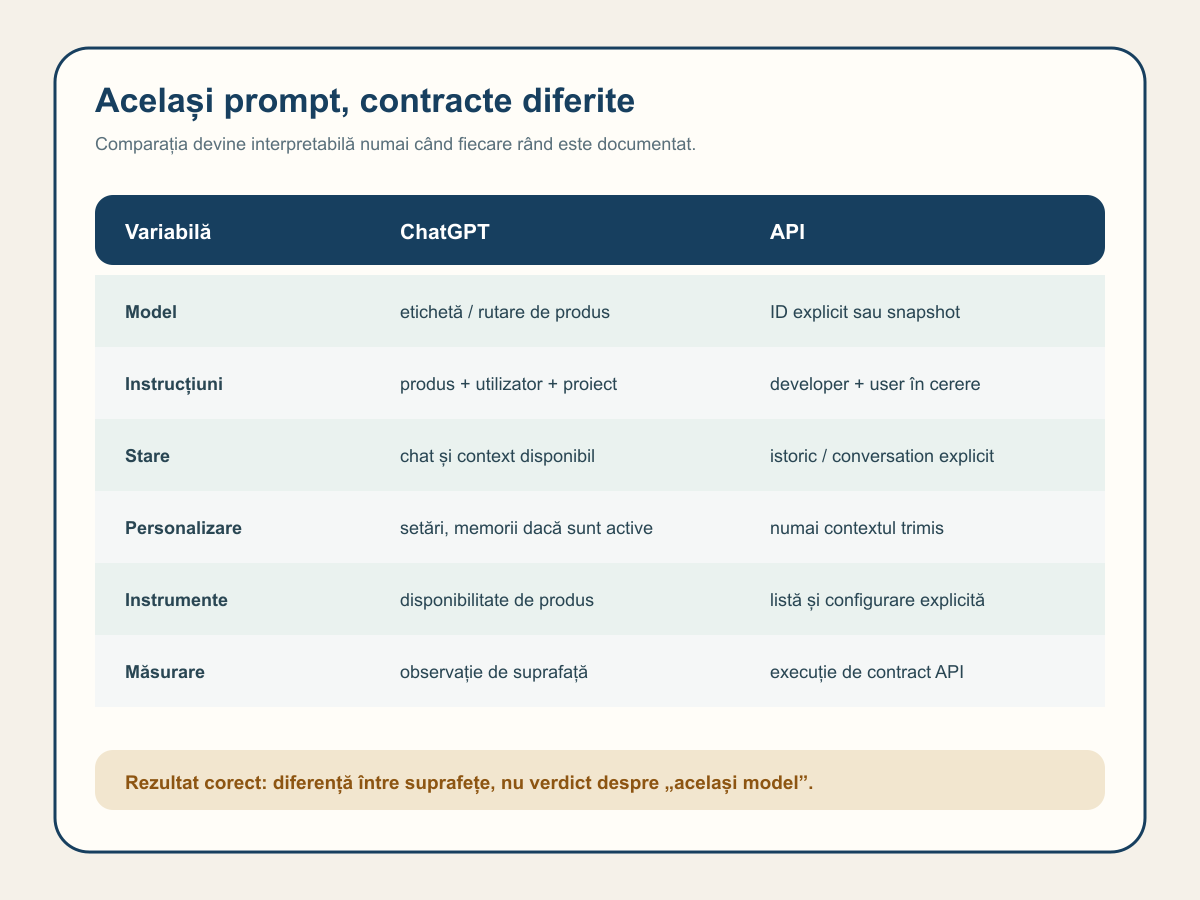
Același prompt trimis în ChatGPT și prin API nu reprezintă același experiment. Interfața ChatGPT este un produs cu instrucțiuni, stare, setări, instrumente și ritm de lansare proprii. API-ul execută o cerere în care dezvoltatorul alege modelul, mesajele, instrumentele și politica de stare. Identitatea textului nu aliniază automat aceste straturi.
Putem construi o comparație utilă, dar concluzia corectă este despre două suprafețe documentate. Nu folosim diferența pentru a afirma că „modelul s-a contrazis” și nu folosim o potrivire accidentală drept dovadă că API-ul reproduce ChatGPT.
1. Promptul vizibil nu este întregul input
Utilizatorul vede propria întrebare. Sistemul poate primi și instrucțiuni de produs, contextul conversației, fișiere, instrumente sau preferințe. În API, dezvoltatorul poate furniza mesaje `developer`, istoric, schema rezultatului și tool-uri. Două șiruri identice pot ajunge astfel în contexte diferite.
Ghidul oficial de prompting arată că scopul, contextul, formatul și limitele schimbă rezultatul. Într-un audit păstrăm toate aceste elemente, nu numai ultimul mesaj.
Aceasta este și granița față de articolul despre de ce un singur prompt nu este o măsurătoare: acolo problema este eșantionarea; aici problema este că unitățile comparate au contracte diferite.
2. Numele modelului nu definește întregul produs
OpenAI documentează `chat-latest` drept pointer către cel mai recent model Instant folosit în ChatGPT și precizează că snapshotul se actualizează regulat. Asta oferă o apropiere la nivel de model, nu o replică a orchestrării, rutării, instrumentelor sau interfeței.
Pentru un studiu longitudinal API, un alias dinamic poate introduce o schimbare fără modificarea codului. Când obiectivul este stabilitatea, folosim un snapshot fix disponibil și înregistrăm ID-ul returnat. Când obiectivul este apropierea de produsul curent, acceptăm dinamismul și marcăm data.
În ChatGPT salvăm eticheta de model pe care produsul o afișează, dacă există, fără să inventăm snapshotul intern. O etichetă comercială și un ID API rămân câmpuri diferite.
3. Starea conversației este administrată diferit
Documentația Responses API spune că cererile de generare sunt independente și stateless dacă nu trimitem istoricul sau nu legăm răspunsurile. Dezvoltatorul poate transmite mesajele, `previous_response_id` ori un obiect Conversation.
În ChatGPT, un mesaj trăiește într-un chat și poate avea turnuri anterioare. Un proiect poate adăuga fișiere sau instrucțiuni. Un test „nou” trebuie să definească dacă folosește un chat nou, un proiect curat sau contextul existent.
În API definim la fel de explicit: fără stare, istoric complet sau conversație persistentă. Dacă o suprafață primește trei turnuri iar cealaltă numai ultimul prompt, nu testăm același journey.
4. Personalizarea poate modifica răspunsul ChatGPT
Documentația de personalizare ChatGPT enumeră personalitatea, instrucțiunile custom și memoriile. Personalitatea schimbă stilul de comunicare, iar instrucțiunile și memoriile pot aduce preferințe ori context între chaturi atunci când sunt active.
API-ul nu moștenește automat setările contului ChatGPT. Primește ceea ce integrarea îi transmite. Pentru o comparație, documentăm personalizarea pe suprafața ChatGPT și recreăm numai elementele cunoscute și permise în mesajele API. Orice diferență rămasă este limitare, nu variabilă ascunsă pe care pretindem că am controlat-o.
Nu folosim contul personal pentru dovezi editoriale. Un mediu de test dedicat reduce contaminarea și protejează istoricul, dar nu transformă produsul în API.
5. Web search trebuie aliniat ca instrument, nu presupus
ChatGPT include web search, iar rezultatele și citările apar când instrumentul este folosit. Disponibilitatea poate fi limitată de setările workspace-ului. Înregistrăm dacă utilizarea căutării este vizibilă în rularea concretă.
În Responses API, instrumentele sunt furnizate explicit, de exemplu `web_search`. Faptul că tool-ul este disponibil nu înseamnă neapărat că aceeași căutare, aceleași interogări ori aceleași pagini vor apărea ca în produs.
O comparație onestă declară: ChatGPT cu search observat versus API cu `web_search` permis și configurația salvată. Dacă una dintre rulări nu caută web-ul, nu comparăm citările ca și cum retrievalul ar fi identic.
6. Instrumentele și sursele conectate lărgesc diferența
ChatGPT poate avea acces la fișiere, proiecte sau surse conectate conform planului și politicilor. API-ul poate primi file search, funcții proprii, MCP sau alte tool-uri. Fiecare instrument adaugă date, permisiuni și comportament.
Pentru audit folosim lista minimă necesară. Dacă întrebarea este despre descoperirea publică a unui brand, excludem fișierele interne din ambele suprafețe. Dacă întrebarea este despre knowledge intern, comparăm două contracte care au aceeași bază documentară și drepturi, nu web public cu documente private.
7. Parametrii API nu au întotdeauna un corespondent vizibil
API-ul permite configurarea explicită a unor aspecte precum modelul, instrumentele, formatul și limita de output. ChatGPT gestionează multe decizii la nivel de produs. Nu inventăm valori pentru setări pe care interfața nu le expune și nu afirmăm că un parametru API „imită” automat comportamentul UI.
Chiar și cu un seed ori cu parametri mai restrictivi, outputurile generative pot varia, iar backendul se poate actualiza. Repetările și versionarea rămân necesare.
8. Exemplu: o întrebare românească despre un brand
Folosim un prompt fictiv: „Recomandă trei servicii românești de contabilitate online pentru un SRL cu cinci angajați. Folosește informații actuale, explică criteriile și citează sursele.” Brandurile din exemplu sunt inventate.
În ChatGPT pornim într-un mediu de test aprobat, într-un chat nou, cu personalizarea documentată și cererea explicită de căutare. Salvăm răspunsul, citările, eticheta modelului afișată și semnalul că web search a fost folosit.
În API trimitem modelul explicit, instrucțiuni neutre, același mesaj user, `web_search`, aceeași limbă și o politică stateless. Salvăm requestul complet, response ID-ul, modelul returnat, tool calls și citările.
Dacă shortlisturile diferă, concluzia este: „cele două contracte au produs liste diferite în această pereche”. Nu spunem că același model s-a contrazis, fiindcă nu am demonstrat identitatea tuturor straturilor.
9. Ce poate fi aliniat și ce rămâne diferență de produs
Putem alinia promptul, limba, momentul, cererea de search, lipsa fișierelor private, formatul dorit și criteriile de adnotare. Putem documenta modelul API, starea și instrumentele.
Nu putem garanta aceleași instrucțiuni interne, rutare, snapshot, query rewriting, rollout, UI post-procesare sau index de căutare. Aceste diferențe rămân în limita raportului. Repetările estimează comportamentul suprafeței, nu elimină necunoscutul.
10. Designul corect are două obiective posibile
Dacă obiectivul este monitorizarea experienței utilizatorului, ChatGPT este suprafața canonică și API-ul nu o înlocuiește. Dacă obiectivul este un pipeline automat reproductibil, API-ul cu model și contract versionate este canonic.
Dacă vrem comparație, construim cohorte pereche și raportăm separat rezultatele. Nu alegem API-ul fiindcă este mai ușor de automatizat și apoi numim metricile „vizibilitate în ChatGPT”. Aceasta ar schimba obiectul măsurat.
11. Fișa minimă ChatGPT
- data, ora, țara, limba și suprafața;
- chat nou sau context documentat;
- personalizare, proiect și fișiere relevante;
- eticheta de model afișată;
- disponibilitatea și folosirea web search;
- promptul, răspunsul și citările complete;
- erori, refuzuri și limitări.
12. Fișa minimă API
- endpointul, SDK-ul și versiunea;
- modelul cerut și cel returnat;
- mesajele developer și user;
- istoricul, conversation ID ori politica stateless;
- tool-urile și configurația lor;
- request ID, output items și citări;
- parametrii, erorile, retry-urile și costul;
- schema de adnotare identică celei din cohortă.
13. Cum raportăm diferența fără concluzii false
Raportul arată fiecare suprafață, coverage-ul și ratele proprii. Pentru perechi afișează acordul shortlistului, suprapunerea surselor și diferențele de afirmații, fără a ascunde rulările eșuate. O singură pereche ilustrează; o cohortă repetată estimează.
Articolul despre conversații multi-turn explică de ce starea schimbă unitatea de analiză. Articolul despre formele de apariție ale brandului oferă codebookul comun.
14. Outputul API poate fi mai ușor de procesat, nu mai „adevărat”
În API putem cere un format structurat, putem salva obiectele tool call și putem valida automat schema. În ChatGPT, evaluatorul lucrează cu răspunsul și semnalele afișate de produs. Diferența de procesabilitate afectează costul colectării, nu calitatea factuală implicită a unui răspuns.
Dacă pipeline-ul API extrage perfect trei branduri din JSON, tot trebuie să verifice dacă recomandarea este condiționată, dacă sursa susține afirmația și dacă entitatea a fost identificată corect. În sens invers, un răspuns ChatGPT dificil de parsificat poate fi bine argumentat și bine citat. Schema dovedește conformitatea formei, nu adevărul conținutului.
Pentru a reduce biasul de evaluare, transformăm ambele rezultate într-un format intermediar comun după capturarea brută: brand, rol, condiție, afirmație, citare și verdict. Nu rescriem răspunsul înainte de arhivare și nu pierdem ordinea ori calificatorii pentru a face suprafețele să pară identice.
15. Driftul trebuie urmărit pe fiecare strat
O schimbare observată în timp poate veni din model, instrucțiuni de produs, disponibilitatea search, index, setări, context sau propriul nostru cod API. Un singur câmp „model version” nu explică toate aceste surse de drift.
Registrul de release păstrează separat data testului ChatGPT, eticheta vizibilă, starea instrumentelor și orice schimbare de setări. Pentru API păstrează snapshotul, versiunea SDK, schema requestului, tool-urile și commitul harnessului. Când unul dintre aceste elemente se schimbă, marcăm un posibil series break și evităm compararea automată cu baseline-ul anterior.
Un test de control stabil, fără branduri reale, poate semnala modificări de format sau tool usage înainte ca dashboardul comercial să se schimbe. El nu identifică singur cauza, dar spune că mediul nu mai este același și că interpretarea cere revalidare.
Verdict
ChatGPT și API-ul pot împărți modele și capabilități, dar nu sunt suprafețe echivalente. Comparația devine utilă când fiecare contract este complet documentat, necunoscutele rămân vizibile și concluzia se referă la ceea ce am testat efectiv.