
Vizibilitatea în AI pentru companiile din România: ghid de pornire
Un ghid practic pentru firmele românești: identitate verificabilă, surse coerente, scenarii locale, baseline reproductibil și un plan de remediere în 30 de zile.
O companie din România poate începe să măsoare și să îmbunătățească vizibilitatea în AI în 30 de zile, fără să confunde un prompt izolat cu piața și fără să presupună că un crawler, schema markup ori mai mult conținut garantează apariția. Prima lună trebuie să producă un pașaport de entitate, un set de scenarii, un baseline reproductibil, o listă de contradicții și un ciclu de remediere.
Ghidul este pentru o echipă care pornește de la zero sau de la observații sporadice. Metodologia completă pentru KPI-uri, conversații, surse și acuratețe rămâne în paginile canonice dedicate; aici le legăm într-o ordine practică pentru piața românească.
1. România are un context de adopție, nu un scor de vizibilitate
Eurostat raportează că în 2025, 5,2% dintre întreprinderile din România cu cel puțin 10 angajați din populația statistică acoperită foloseau tehnologii AI, față de 20,0% la nivelul UE. Raportul Digital Decade pentru România spune separat că digitalizarea întreprinderilor, mai ales a IMM-urilor, rămâne sub media UE.
Aceste cifre măsoară adopția în companii. Nu ne spun câți clienți români folosesc răspunsuri AI pentru a alege un furnizor și nici cât de vizibil este un anumit brand. O firmă poate folosi puțin AI intern și totuși să fie frecvent recomandată; alta poate automatiza procese, dar să lipsească din răspunsurile despre categorie.
Pornim deci cu o măsurare proprie. Articolul despre ce este vizibilitatea în AI separă prezența, proeminența, recomandarea, citarea și acuratețea. Nu comprimăm aceste dimensiuni într-un singur „scor România”.
2. Delimităm compania pe care vrem să o măsurăm
Înainte de prompturi, echipa scrie o fișă de scop:
- entitatea juridică și brandurile comerciale incluse;
- produsele ori serviciile active;
- România întreagă, anumite județe, orașe sau zone de servicii;
- B2C, B2B, sector public ori combinații distincte;
- română, engleză și eventual germană, dar ca piețe separate;
- descoperire, comparație, reputație, suport sau cumpărare;
- concurenții și alternativele reale din fiecare scenariu;
- data de referință și proprietarul intern al auditului.
„Brandul nostru în AI” este prea larg. Un producător din Brașov poate avea scenarii diferite pentru clienți români, distribuitori germani și candidați la angajare. O clinică are scenarii de locație și specialitate; un SaaS are integrare, securitate și comparație. Le amestecăm doar dacă vrem un rezultat imposibil de interpretat.
3. Construim pașaportul de entitate
Pașaportul este referința împotriva căreia verificăm sursele și răspunsurile. Include numele legal, forma juridică, brandul, aliasurile aprobate, domeniul canonic, serviciile, locațiile, zonele deservite, contactele, limbile, relațiile de grup și istoricul de rebranding.
ONRC oferă servicii și informații oficiale despre profesioniștii înregistrați. Datele legale curente pot ancora identitatea, dar site-ul trebuie să explice și brandul comercial în limbajul clientului. Nu publicăm date personale ori informații din registre cu acces limitat doar pentru „optimizare”.
Pentru fiecare câmp notăm sursa, proprietarul și data verificării. Dacă numele din footer, pagina Despre, factură, profilurile locale și comunicate diferă, problema precedă orice audit AI. Stabilim relația corectă: „Brand X este operat de Societatea Y”, nu alternăm denumirile fără explicație.
4. Separăm identitatea legală, brandul și locația
O entitate poate opera mai multe branduri. Un brand poate avea mai multe locații. Un sediu social nu este automat punct de lucru pentru clienți. O zonă de servicii nu este adresă fizică. Aceste distincții trebuie să fie identice în paginile proprii și profilurile controlate.
Google Business Profile cere reprezentarea consecventă a numelui real, adresei ori zonei de servicii, programului și categoriei. Regula este specifică platformei, dar disciplina ajută orice sistem care încearcă să rezolve entitatea și locația.
Nu adăugăm servicii ca keyword-uri în numele firmei și nu inventăm puncte de lucru virtuale. Pentru profesioniști individuali, departamente ori francize verificăm politica suprafeței și relația reală. Acuratețea este mai importantă decât densitatea termenilor.
5. Inventariem sursele după autoritatea lor
| Clasă | Exemple | Ce poate dovedi |
|---|---|---|
| proprii | site, documentație, catalog, politici | oferta și afirmațiile aprobate |
| oficiale | registre, autorități, emitent de licență | identitate, statut sau autorizare în scopul lor |
| comerciale | marketplace, distribuitor, platformă locală | ofertă și disponibilitate la acel comerciant |
| independente | presă, analize, review-uri | observații, reputație și experiență |
| sociale | profiluri și conversații publice | semnale recente, nu adevăr universal |
Sursele nu au o ierarhie unică. ONRC poate fi autoritativ pentru identitatea juridică, nu pentru calitatea unui produs. Producătorul poate fi autoritativ pentru specificație, nu pentru experiența fiecărui client. Un review poate documenta o experiență, nu schimba programul oficial al locației.
Articolul despre sursele folosite când motoarele AI vorbesc despre un brand explică analiza citărilor. În ghidul de pornire construim doar harta: URL, tip de sursă, afirmații, proprietar, dată, accesibilitate și contradicții.
6. Verificăm dacă paginile importante pot fi accesate
Primul control tehnic este banal și decisiv: pagina canonică trebuie să răspundă cu HTTP 200, să conțină text util, să nu fie blocată accidental și să fie legată intern. Sitemapul, canonical-ul, robots directives și randarea JavaScript intră în aceeași verificare.
Cerințele tehnice minime Google sunt crawler neblocat, răspuns 200 și conținut indexabil; documentația precizează că indexarea nu este garantată. OpenAI recomandă să nu fie blocat OAI-SearchBot pentru conținutul care poate intra în rezumate și fragmente, fără să promită apariția sau poziția.
Nu deschidem tot site-ul oricărui bot necunoscut. Verificăm user-agent-ul și intervalele publicate de operator, protecția CDN, rate limiting-ul și politica de conținut. Zonele private, coșul, conturile și datele clienților rămân protejate.
7. Datele structurate ajută dezambiguizarea, nu cumpără vizibilitate
Pe homepage ori pagina canonică de organizație putem exprima numele, legalName, alternateName, URL, logo, contact, adresă și profiluri oficiale prin vocabularul Schema.org Organization. Marcăm numai informații vizibile și adevărate.
Google spune că Organization structured data poate ajuta la înțelegerea și dezambiguizarea organizației. „Poate ajuta” nu înseamnă că produce knowledge panel, citare ori recomandare. Testăm validitatea markup-ului și concordanța cu pagina, apoi măsurăm separat rezultatele.
Nu folosim sameAs pentru orice mențiune, director sau pagină necontrolată. Linkurile trebuie să reprezinte identitatea oficială a aceleiași entități, nu să mimeze popularitatea.
8. Construim 25–50 de scenarii românești
Setul inițial trebuie să acopere decizii, nu variații artificiale ale aceleiași fraze:
- brand: „Ce face compania X?”, „Unde operează?”, „Cum o contactez?”;
- categorie: „Ce furnizori oferă soluția Y în România?”;
- nevoie: „Am problema Z; ce tip de serviciu mi se potrivește?”;
- comparație: „X sau alternativa Y pentru contextul acesta?”;
- încredere: certificări, metodă, garanții, retur, experiență;
- local: oraș, județ, zonă de livrare ori intervenție;
- acțiune: ofertă, programare, achiziție, contact sau vizită.
Folosim română naturală cu diacritice. Adăugăm variante fără diacritice doar când există motiv de comportament, nu duplicăm automat toate prompturile. Aliasurile, prescurtările și vechile nume intră controlat, cu etichetă.
Separăm scenariile de brand de cele fără brand. Primele verifică entitatea și acuratețea. Celelalte măsoară descoperirea și competiția. Dacă numitorul se schimbă, se schimbă și răspunsul KPI-ului, așa cum arată ghidul despre numitori în măsurarea vizibilității AI.
9. Protocolul face baseline-ul reproductibil
Pentru fiecare observație salvăm:
- ID-ul scenariului și intenția;
- promptul exact și contextul anterior;
- motorul, interfața și modelul afișat, dacă este vizibil;
- data, ora și frecvența rulării;
- limba, piața, locația și starea autentificării;
- răspunsul, citările și URL-urile în limitele permise;
- prezența, poziția, tipul recomandării și afirmațiile;
- evaluatorul, dovada și starea verificării.
OpenAI documentează că ChatGPT Search poate reformula întrebarea în interogări țintite și poate folosi locația pentru rezultate relevante. Acesta este un exemplu de motiv pentru care interfața și contextul apar în protocol.
Un răspuns delogat și unul dintr-o conversație personalizată nu sunt probe echivalente. Nu folosim contul personal pentru capturi editoriale și nu publicăm sidebar, istoric sau date de cont. Dacă o sesiune fără cont cere autentificare, notăm limita în cercetare internă; nu transformăm ecranul de login în „dovadă”.
10. Măsurăm separat prezența, recomandarea, citarea și adevărul
Baseline-ul minim are patru registre:
- prezență: apare compania în răspunsul eligibil?
- recomandare: este doar menționată, inclusă în listă sau aleasă?
- citare: ce surse susțin răspunsul și ce afirmații?
- acuratețe: afirmația este corectă, incorectă, neconfirmată sau depășită?
Un brand poate avea prezență mare și informații greșite. Altul poate fi citat ca sursă fără să fie recomandat. Un al treilea poate fi corect descris doar în prompturile cu numele lui. Fiecare situație are altă intervenție.
Nu dăm un scor de 73/100 fără formula, universul și intervalul de observație. Pentru primul ciclu sunt mai utile ratele pe scenarii eligibile, numărul contradicțiilor critice și acoperirea surselor necesare deciziei.
11. Verificăm afirmațiile atomice despre companie
Descompunem răspunsul: anul fondării, locația, produsele, prețul, certificarea, acoperirea, politica ori relația de proprietate sunt afirmații separate. Fiecare primește dovadă, dată și verdict.
Ghidul despre ce spune AI despre brand și cum verificăm oferă cadrul complet. În proiectul românesc prioritizăm:
- informații care pot schimba o decizie de cumpărare;
- date juridice ori de contact incorecte;
- servicii retrase prezentate ca active;
- confuzii între brand, entitate și altă firmă cu nume apropiat;
- certificări sau autorizări fără emitent, domeniu și valabilitate;
- preț, stoc și program fără momentul observației.
12. Remediem sursa înainte să cosmetizăm outputul
Dacă răspunsul preia o adresă veche din pagina de contact, corectăm pagina, markup-ul și profilurile controlate. Dacă un serviciu nu are pagină clară, construim pagina canonică. Dacă o afirmație independentă este falsă, cerem corecția prin procesul publicației; nu publicăm zece articole proprii care repetă contrariul.
Ordinea de prioritate poate fi:
- contradicție critică și răspândită;
- pagină canonică lipsă pentru o decizie importantă;
- identitate ori locație inconsistentă;
- dovadă absentă pentru o afirmație sensibilă;
- pagină inaccesibilă ori greu de extras;
- acoperire insuficientă a întrebărilor relevante;
- îmbunătățire editorială fără impact demonstrat.
Ghidul Google pentru funcțiile generative păstrează cerințele tehnice și bunele practici Search și precizează că respectarea lor nu garantează crawling, indexare sau afișare. Același realism trebuie păstrat în orice proiect GEO.
13. Primele pagini trebuie să răspundă deciziilor reale
În loc de 100 de articole generice, o companie pornește de obicei cu:
- Despre/Companie — identitate, istoric, relația legal–brand;
- câte o pagină pentru serviciile ori produsele prioritare;
- locații și zone de servicii distincte, dacă sunt reale;
- metodologie, proces sau „cum lucrăm”;
- preț ori model comercial, când poate fi publicat;
- politici de livrare, retur, garanție, suport și confidențialitate;
- certificări și dovezi cu emitent și domeniu;
- studii de caz verificabile, nu testimoniale anonime;
- FAQ construit din întrebări reale și limite explicite;
- contact și următorul pas fără ambiguitate.
Fiecare pagină are o intenție canonică. Nu clonăm același text pentru fiecare oraș dacă nu există serviciu, echipă, dovadă ori informație locală distinctă. Expansiunea fără valoare unică creează zgomot și canibalizare.
14. Româna, engleza și germana sunt piețe, nu trei coloane de traducere
Versiunea română definește compania pentru România. Engleza poate servi parteneri internaționali, iar germana o piață de export; ofertele, dovezile, termenii și întrebările pot diferi. Traducerea titlului nu creează automat relevanță locală.
Păstrăm identitatea canonică, dar localizăm terminologia, exemplele, unitățile și call-to-action-ul. Folosim hreflang când paginile sunt echivalente și canonicals corecte, fără să facem canonical din toate limbile spre română. Afirmațiile juridice ori comerciale primesc verificare pe piață.
Diacriticele sunt forma editorială normală. Aliasurile fără diacritice pot apărea în măsurare sau metadata acolo unde sunt natural folosite, nu degradăm conținutul pentru a imita tastarea rapidă.
15. Domeniile reglementate au un prag mai înalt
Sănătatea, finanțele, dreptul, educația acreditată și alte servicii sensibile nu pot trata optimizarea ca simplă producție de copy. Licențele, limitele serviciului, autorii, data și sursele trebuie revizuite de persoanele responsabile.
Nu prezentăm o acreditare expirată ca activă, o opinie ca fapt ori o estimare ca preț ferm. Dacă o afirmație nu poate fi publicată legal sau responsabil, nu încercăm să o „facem vizibilă”. Auditul GEO moștenește guvernanța domeniului.
16. Planul de 30 de zile
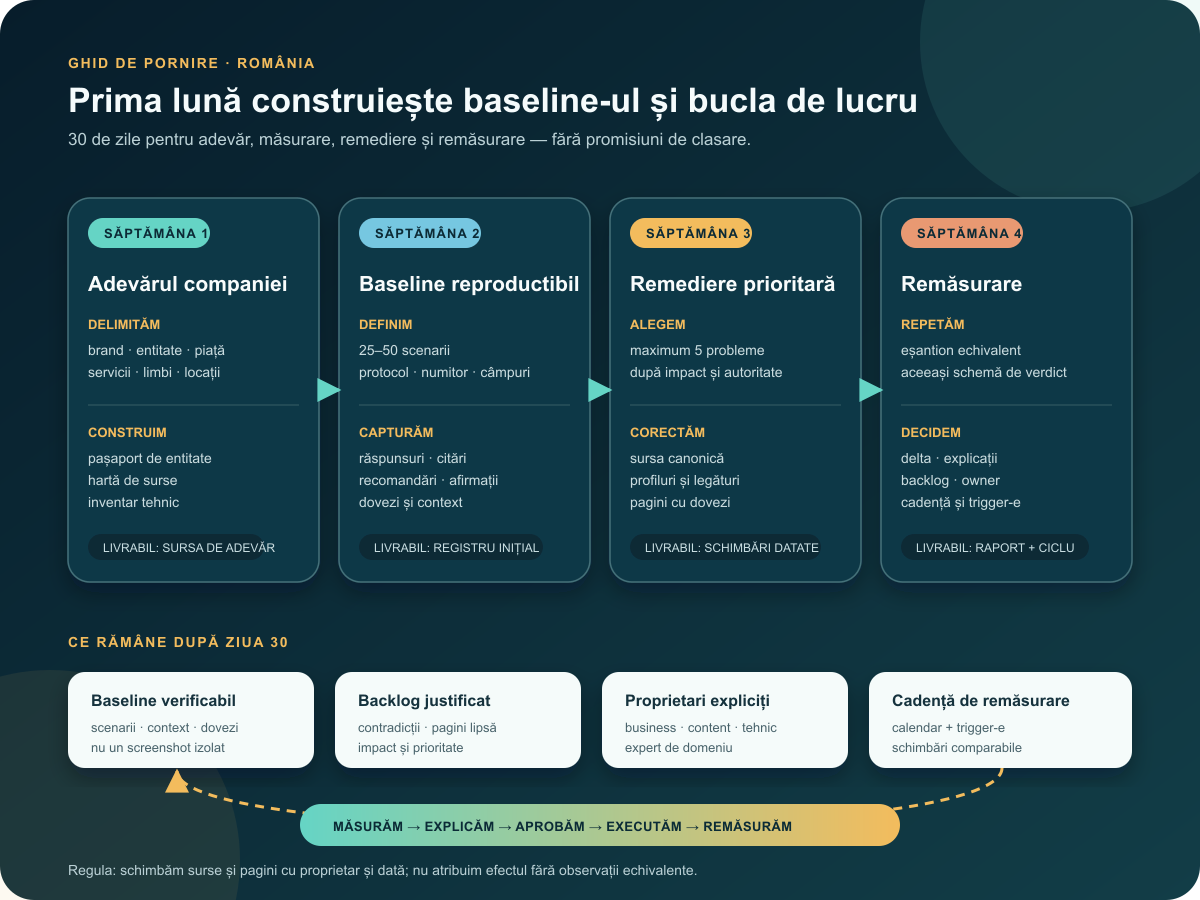
Săptămâna 1 — adevărul companiei
Definim scopul, pașaportul, piețele și proprietarii. Inventariem paginile și sursele externe importante. Verificăm nume, locații, servicii, contacte, crawlability, statusuri HTTP, sitemap, canonical și markup de organizație.
Săptămâna 2 — baseline-ul
Construim 25–50 de scenarii, protocolul și schema de evaluare. Rulăm eșantionul pe interfețele alese, păstrăm răspunsurile și citările, rezolvăm entitățile și clasificăm afirmațiile. Nu schimbăm metodologia după ce vedem rezultatele.
Săptămâna 3 — remedierea
Alegem maximum cinci contradicții sau lipsuri cu impact. Corectăm sursa canonică, legăturile și profilurile controlate. Construim paginile lipsă cu dovezi și marcăm data schimbării. Nu promitem efect imediat.
Săptămâna 4 — remăsurarea
Rulăm același eșantion sau subsetul prestabilit, comparăm numai observații echivalente și documentăm ce s-a schimbat. Stabilim backlogul, frecvența, trigger-ele de recontrol și un raport scurt pentru management.
17. Echipa minimă și responsabilitățile
| Rol | Responsabilitate |
|---|---|
| owner de business | scop, priorități, risc și aprobare |
| brand/content | pașaport, surse, pagini și localizare |
| SEO/tehnic | acces, indexare, markup, analytics și QA |
| analist | scenarii, rulări, clasificare și raport |
| expert de domeniu | afirmații tehnice, juridice ori reglementate |
Într-o firmă mică, aceeași persoană poate acoperi mai multe roluri, dar aprobările rămân explicite. Cel care redactează nu își validează singur afirmațiile sensibile. Modificările de preț, serviciu, locație, brand sau politică declanșează recontrol.
18. Ce nu facem în prima lună
- nu declarăm succes după un răspuns favorabil;
- nu cumpărăm un scor fără să înțelegem numitorul;
- nu generăm sute de pagini înaintea pașaportului și a baseline-ului;
- nu copiem răspunsuri AI în paginile oficiale ca sursă de adevăr;
- nu eliminăm diacriticele din tot conținutul;
- nu blocăm ori permitem crawlere fără inventar și politică;
- nu publicăm capturi din conturi personale;
- nu confundăm trafic referral cu recomandare sau conversie;
- nu atribuim unei schimbări efectul fără control temporal;
- nu promitem poziție, citare ori includere.
Verdict
Pentru o companie din România, vizibilitatea în AI începe cu identitatea corectă și un protocol mic, repetabil. În 30 de zile putem afla unde apare compania, cum este descrisă, ce surse sunt folosite, ce afirmații sunt greșite și ce pagini lipsesc. Nu putem garanta cum va răspunde un sistem extern.
Rezultatul bun al primei luni nu este „am optimizat pentru AI”. Este o buclă funcțională: măsurăm aceleași scenarii, reparăm sursele cu autoritate, aprobăm schimbările și remăsurăm. Abia după această disciplină merită extins catalogul de conținut, limbile, industriile și automatizarea.
Surse
- Eurostat — 20% of EU enterprises use AI technologies
- Comisia Europeană — Romania 2025 Digital Decade Country Report
- ONRC — Servicii online
- Google Business Profile — Guidelines for representing your business
- Google Search Central — Organization structured data
- Google Search Central — Technical requirements
- Google Search Central — Generative AI optimization guide
- OpenAI — Publishers and Developers FAQ
- OpenAI — ChatGPT Search
- Schema.org — Organization
Ghidul este un model editorial și operațional independent. Nu garantează includerea, citarea sau recomandarea într-un sistem AI extern și nu descrie o funcție AYSA ca fiind lansată.